

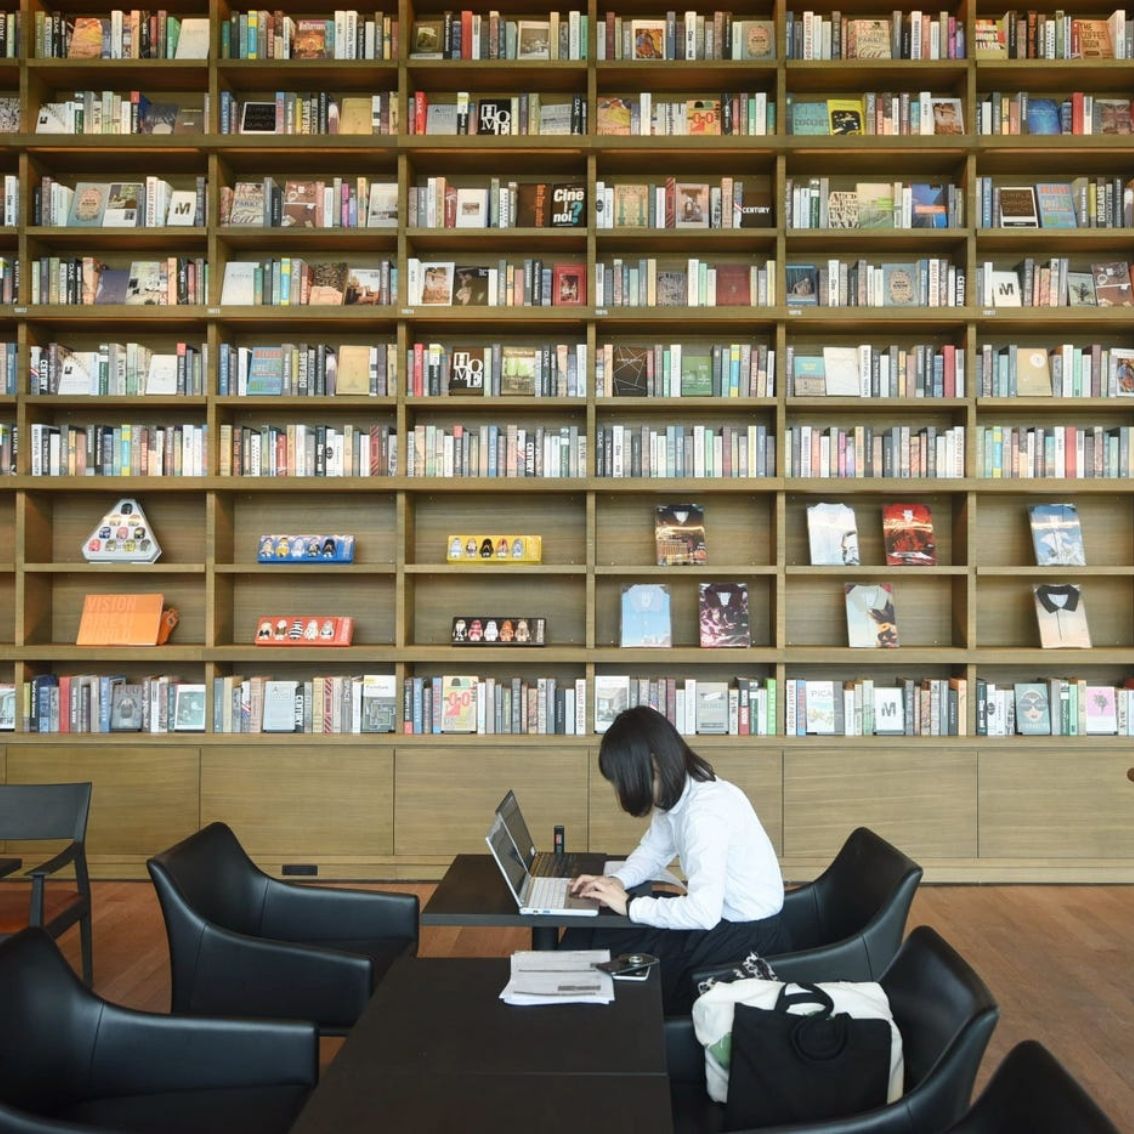
Contra as empresas que destroem livros para treinar a IA
Fotografia: Feature China // Getty Images
Uma breve história das distopias, dos cortadores hidráulicos de papel, das escolas sem ecrãs e das questões relacionadas com os direitos de autor.
A Anthropic, uma empresa fundada em 2021 para desenvolver modelos de IA como o Claude, parece ter evitado acusações de violação de direitos de autor no treino dos seus modelos através da compra, digitalização e destruição de um grande número de livros. A Anthropic, fundada por antigos membros da OpenAI, incluindo os irmãos Daniela e Dario Amodei, é uma Public Benefic Corporation, ou seja, uma empresa com fins lucrativos obrigada a gerar um impacto positivo na sociedade e no ambiente. Entre outras coisas, a Anthropic redigiu a constituição do Claude, apoiou duas propostas políticas — uma sobre a governação da IA para prevenir implementações perigosas e outra para proteger os trabalhadores das mudanças induzidas pela IA no mercado de trabalho — e, em março, negou ao Pentágono que os seus modelos estivessem a ser utilizados para desenvolver sistemas de vigilância em massa e armas autónomas. Mais recentemente, a Anthropic cumpriu a regulamentação europeia ao aplicar uma marca de água aos textos gerados pelo Claude; no entanto, tal como o Washington Post noticiou no início deste ano, a Anthropic — e talvez não seja a única — implementou o Projeto Panamá, "a nossa tentativa de digitalizar de forma destrutiva todos os livros do mundo". Entre 500 mil e 2 milhões de livros — a maioria dos publicados até 2022 — seriam adquiridos em cerca de seis meses, para depois serem hidraulicamente desencadernados e digitalizados, décadas após a publicação do perturbadoramente atual Fahrenheit 451, de Ray Bradbury.
Porquê destruir livros depois de os digitalizar?
A importância da leitura e do pensamento crítico na era dos algoritmos, bem como os riscos da dependência das redes sociais, têm vindo a ser debatidos há muito tempo, pelo menos desde 2020, com o documentário da Netflix The Social Dilemma, e especialmente desde 2025, com o livro de Sarah Wynn-Williams, Careless People. Recentemente, por exemplo, @prolissopodcast lembrou-nos neste vídeo que "daqui a alguns anos, a leitura será um luxo para milionários", que "Bill Gates só deu um telemóvel aos filhos quando estes fizeram catorze anos", que "Tim Cook não deixa o neto tocar nas redes sociais" e que "o fundador do Snapchat permite que os filhos passem uma hora e meia por semana em frente ao ecrã", e "no coração do Vale do Silício, há uma escola sem ecrãs", e "as pessoas que programam os algoritmos que o mantêm acordado à noite pagam propinas astronómicas para manter os seus filhos afastados desses ecrãs". Fala-se também da chamada "bolha" da IA: Rudy Bandiera, na sua newsletter, calculou que as vinte empresas que dominam o mercado da inteligência artificial valeriam trinta e quatro biliões de dólares na bolsa de valores e que este valor "se baseia num pressuposto específico, nomeadamente que a IA irá repetir o que aconteceu com a Internet há vinte e cinco anos, quando, de centenas de empresas, apenas um punhado de gigantes permaneceu de pé — Google, Amazon, Meta — e quem veio depois ficou com as migalhas".
Uma investigação da 404 Media revelou, a 21 de julho de 2026, que uma empresa chamada ISBNdb, apresentada como "a maior base de dados de livros do mundo", tinha vindo a fornecer livros impressos a empresas de IA para que estas os pudessem utilizar no treino dos seus modelos. A 404 Media chegou mesmo a criar uma página dedicada ao serviço, salientando que "os melhores dados de treino de IA do mundo estão ali mesmo, numa prateleira" e que os livros "representam conhecimento humano selecionado, revisto por pares e específico de cada área, de uma forma que nenhum motor de busca consegue replicar. Denso, editado, fidedigno". Uma semana depois, a ISBNdb removeu imediatamente a página intitulada "Fornecimento de livros impressos para as suas necessidades de conjuntos de dados de LLMs de IA" e emitiu uma breve declaração: "Compreendemos as preocupações. A ISBNdb nunca comprou, digitalizou ou vendeu um livro para treinar modelos de IA. Não treinamos modelos de IA e nunca o fizemos. A página foi um teste de mercado". O que se pode dizer?
A favor da utilização de livros para treinar a IA, argumenta-se que muitos textos já se encontram digitalizados: veja-se o Project Gutenberg, provavelmente a biblioteca digital mais antiga do mundo, fundada em 1971 por Michael Hart e que conta com 79 mil e 177 títulos. Parece também que é ilegal digitalizar (e, portanto, duplicar) um livro e guardar uma cópia do mesmo, incluindo o original. Muitas livrarias, por razões óbvias de lucro, concordaram em disponibilizar catálogos completos às empresas, especialmente de volumes publicados até 2022 e, portanto, isentos de potencial "contaminação" por IA. "Tradicionalmente", lê-se num artigo da Futurism, "os livros têm sido úteis para duas coisas: ler e ficar bem numa estante, mas as empresas de IA não estão interessadas em nenhuma delas". Em junho de 2025, um juiz decidiu a favor da Anthropic numa decisão histórica, argumentando que "o objetivo de treino se enquadra no uso justo" e é, por isso, permitido pela legislação dos EUA, tal como aconteceu com a digitalização de milhões de livros pelo Google Books em 2004. Nesse caso, porém, pelo menos o Google tinha digitalizado os livros sem os destruir. Talvez fosse menos prático. Certamente causou menos alvoroço.
Traduzido do original, disponível aqui.
_Top Esquire

.jpg)
.jpg)
 By Matthew Albanese
_Top Esquire
.jpg)
.jpg)